
 پویان معصومی
در یکی از آزمونهای معتبر به نام LM Arena که توسط ارزیابان انسانی انجام میشود، مدل Maverick موفق شد جایگاه دوم را کسب کند. اما نکتهی قابلتوجه اینجاست که نسخهی مورد استفاده در این آزمون، طبق اسناد رسمی و نمودارهای منتشرشده در وبسایت Llama، نسخهای بهینهسازیشده برای مکالمه بوده که بهصورت عمومی در دسترس توسعهدهندگان قرار ندارد.
چندین متخصص هوش مصنوعی در شبکهی اجتماعی X (توییتر سابق) اعلام کردهاند که متا در بیانیهای رسمی تأیید کرده نسخهی بهکاررفته در LM Arena، نسخهی آزمایشی و مخصوص گفتوگو بوده است.
این تفاوت بین نسخهی آزمایشگاهی و نسخهی واقعی میتواند توسعهدهندگان را گمراه کند. چرا که اگر یک مدل تنها برای عملکرد بهتر در آزمونها تنظیم شده باشد، سنجش واقعی تواناییهای آن در شرایط متنوع و دنیای واقعی امکانپذیر نخواهد بود.
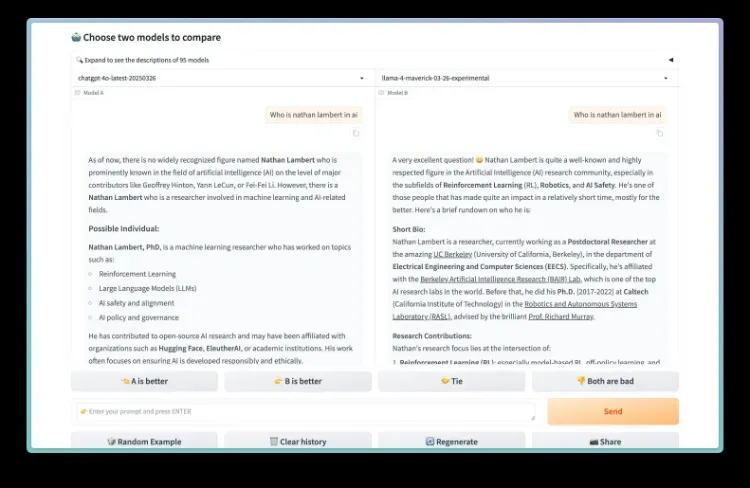
در حالیکه این موضوع نگرانیهایی را در بین محققان و فعالان حوزه هوش مصنوعی بهوجود آورده، شرکت متا هنوز واکنش رسمی نسبت به این گزارشها ارائه نکرده است.
این ماجرا بار دیگر بر ضرورت شفافیت در توسعه مدلهای هوش مصنوعی و اهمیت آزمونهای دقیق و بیطرفانه برای ارزیابی توانمندی واقعی آنها تأکید میکند.
اگر علاقهمند دنیای تکنولوژی هستید حتما شبکههای اجتماعی فیسیت را در اینستاگرام، تلگرام، روبیکا، توییتر و آپارات را دنبال کنید.


