
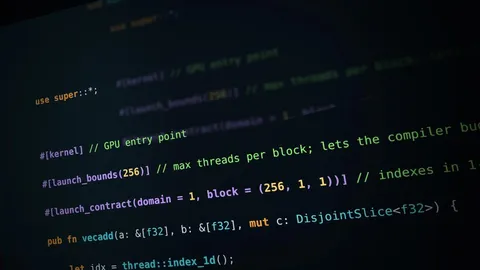
در ۸ سپتامبر ۲۰۲۶ انویدیا در وبلاگ فنی خود از CUDA Rust خبر داد: طرحی برای نوشتن بومی کرنلهای GPU به زبان راست. پیشتر میشد کرنل را از راست فراخواند؛ هدف تازه این است که خودِ کرنل هم به راست نوشته شود و مستقیم به PTX کامپایل شود، نه بهصورت پوشش روی زبانی دیگر.
طبق همان منبع، لایههای سامانهای هوش مصنوعی — موتورهای استنتاج، زیرساخت سرویسدهی، درایورها و زماناجرای عاملها — بیش از پیش با راست نوشته میشوند؛ نمونههایی مثل درایور لینوکس Nova، هستهٔ Dynamo و اتصالات NVTX. با این حال کرنل GPU معمولاً هنوز به زبان دیگری است. CUDA Rust همین شکاف را پر میکند.
دو مسیر: SIMT و Tile
انویدیا دو مسیر همتراز با مدلهای موجود CUDA معرفی کرده است. مسیر نخست SIMT است؛ همان الگویی که در CUDA C++ یا numba-cuda رایج است: رفتار یک نخ را توصیف میکنید و هزاران نمونه پرتاب میشود. مسیر دوم مدل Tile است که در C++ و پایتون هم هست: کار یک کاشی داده را مینویسید و کامپایلر Tile IR نگاشت نخ و چیدمان حافظه را مدیریت میکند. شرکت پیشنهاد کرده ابتدا Tile را امتحان کنید و فقط وقتی به کنترل دستی حافظه و نخها نیاز دارید سراغ SIMT بروید.
پروژهٔ cuda-oxide مسیر SIMT را پیاده میکند؛ بکاند سفارشی codegen برای rustc که توابع با ویژگی #[kernel] را از طریق MIR، چارچوب Pliron و LLVM به PTX میرساند. برای اجرا لینوکس، GPU با قابلیت محاسباتی ۸٫۰ یا بالاتر، CUDA Toolkit ۱۲٫x یا جدیدتر، clang با سرآیندهای libclang و زنجیرهٔ nightly پینشده لازم است. دستور cargo oxide doctor وابستگیها را چک میکند. وضعیت اعلامشده: آلفا زودهنگام.
پروژهٔ cutile-rs مسیر Tile را پوشش میدهد. ماکروی #[cutile::module] درخت نحوی کرنل را در باینری میزبان جاسازی میکند و در نخستین پرتاب، از طریق CUDA Tile IR بهصورت JIT کامپایل میشود. نیازمندیها سبکتر است: GPU با قابلیت ۸٫۰ یا بالاتر، CUDA ۱۳٫۳، راست پایدار ۱٫۸۹ یا جدیدتر و لینوکس؛ بدون nightly یا LLVM جداگانه. cutile روی crates.io منتشر شده و به گفتهٔ انویدیا بیرون از شرکت در موتور استنتاج Grout هاگینگفیس و در mistral.rs به کار رفته است. پوشش هنوز ناقص است و APIها تغییر خواهند کرد.
ایمنی حافظه در زمان کامپایل
در هر دو مسیر، ورودیها بهصورت مشترک خوانده میشوند و خروجی فقط به یک نویسنده تعلق دارد. در cuda-oxide نوع DisjointSlice دسترسی انحصاری هر نخ به عنصر خودش را تضمین میکند؛ چون &mut [f32] برای هزاران نخ همزمان شکل مناسبی نیست. پرتاب هم با قرارداد #[launch_contract] و تابع آمادهسازی در برابر محدودیتهای زندهٔ دستگاه اعتبارسنجی میشود. در cutile-rs پارتیشنبندی روی میزبان برای تانسورهای قابلنوشتن، مالکیت انحصاری هر کاشی را برقرار میکند و هندسهٔ شبکه از همان پارتیشن بهدست میآید. مثالهای مطلب، خطای کلاسیک aliasing را در زمان کامپایل متوقف میکنند.
انویدیا گفته قصد دارد همکاری بینزبانی میان CUDA Rust، CUDA C++ و CUDA Python را پشتیبانی کند تا انتخاب یک فرانتاند شما را از بقیهٔ اکوسیستم جدا نکند. هر دو پروژه اولیه و غیرآماده برای تولید اعلام شدهاند؛ از توسعهدهندگان خواسته شده اشکالها را گزارش کنند. ارائهٔ مرتبط «Fearless Concurrency on the GPU» در RustConf ۲۰۲۶ از ۸ تا ۱۱ سپتامبر در مونترال هم اعلام شده است.
- تاریخ اعلام: ۸ سپتامبر ۲۰۲۶ در وبلاگ فنی انویدیا
- cuda-oxide: مسیر SIMT، آلفا زودهنگام، نیازمند nightly و لینوکس
- cutile-rs: مسیر Tile، راست پایدار، منتشر روی crates.io
- هر دو هنوز برای تولید انبوه آماده نیستند
- هدف میانمدت: همکاری بینزبانی با CUDA C++ و پایتون
وضعیت آمادهبودن این ابزارها را برای پروژههای تولیدی چطور ارزیابی میکنید؟


