
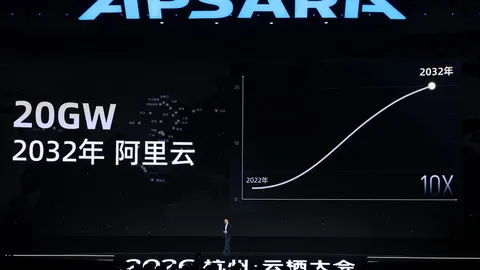
علیبابا در ۲۲ سپتامبر ۲۰۲۶ در کنفرانس سالانهٔ آپسارا (Apsara Conference) در هانگژو، مجموعهای از بهروزرسانیها را در مسیر فولاستک هوش مصنوعی اعلام کرد. در بیانیهٔ رسمی علیبابا کلود، این اعلامها شامل مدلهای پایهٔ Qwen، تراشههای اختصاصی، ابر عاملمحور و بستر ایجنت برای گوشیهای هوشمند میشود.
جو تسای، رئیس هیئتمدیرهٔ گروه علیبابا، موضوع کنفرانس را «هوش فراتر میرود» توصیف کرد و گفت هوش مصنوعی میتواند در سناریوهای واقعی مقیاسپذیر شود و بهرهوری صنایع را افزایش دهد. ادی وو، مدیرعامل گروه، نیز حجم «تفکر ماشینی» را کمتر از ۳٪ تفکر انسانی دانست و هدف شرکت را رساندن ظرفیت جهانی مراکز دادهٔ علیبابا کلود به بیش از ۲۰ گیگاوات تا سال ۲۰۳۲ اعلام کرد.
تراشهٔ Zhenwu V900 و مشخصات اعلامشده
واحد طراحی تراشهٔ تیهد (T-Head) پردازندهٔ آموزش و استنتاج Zhenwu V900 را معرفی کرد. به گفتهٔ علیبابا کلود، این تراشه سه برابر عملکرد نسل قبلی Zhenwu M890 را که در ماه مه عرضه شده بود ارائه میدهد، دارای ۲۱۶ گیگابایت حافظهٔ GPU و پهنای باند بینتراشهای ۱٬۲۰۰ گیگابایت بر ثانیه است و از دقتهای بومی از جمله FP8 و FP4 پشتیبانی میکند. زمان تولید انبوه و عرضهٔ تجاری آن فصل اول ۲۰۲۷ اعلام شدهاست.
طبق همان بیانیه، تراشههای Zhenwu تاکنون بیش از ۶۵۰ مشتری در صنایعی مانند خودرو، مالی، مدلهای زبانی بزرگ، هوش تجسمیافته، انرژی و تولید را پوشش دادهاند. علیبابا همچنین سرور سوپرنود ارتقایافتهای را معرفی کرد که پردازندهٔ V900، سوئیچ ICN، SmartNIC از نوع Panmai و کنترلر SSD ژنیوئه را یکپارچه میکند و میتواند خوشهای تا ۵۰۰٬۰۰۰ کارت را پشتیبانی کند.
در نقشهٔ راه پردازندهٔ مرکزی نیز Yitian ۷۲۰ با تمرکز بر عملکرد تکهسته، تراکم هسته و بهرهوری انرژی نسبت به Yitian ۷۱۰ معرفی شده و Yitian ۷۳۰ بهعنوان نخستین CPU مبتنی بر ریزمعماری اختصاصی تیهد با افزایش تا ۴۰٪ در SPECint2017/GHz نسبت به ۷۱۰ برای سال ۲۰۲۷ برنامهریزی شدهاست.
خوانندگان میتوانند دیدگاه خود را دربارهٔ اهمیت تراشههای بومی ابری در بخش نظرات ثبت کنند.
مدلهای Qwen ۴ و ارتقای چندرسانهای
علیبابا اعلام کرد مدل نسل بعدی Qwen ۴ در حال آموزش است و نقشهٔ راه سریهای Qwen ۴٫۵ و Qwen ۵ را با مقیاس پیشبینیشدهٔ ۵ تا ۱۰ تریلیون پارامتر ترسیم کردهاست. در آزمایشهای بهبود بازگشتی خودمختار، بهروزرسانی Qwen3.8-Max امتیاز Artificial Analysis را از ۴۰ به ۴۵ رساند؛ در یک آزمایش طراحی تراشه نیز مدل بیش از ۶۰ ساعت خودبهبودی داشت، بیش از ۱۰٬۰۰۰ فراخوان ابزار EDA انجام داد و مساحت ماژول باس را بدون افت عملکرد ۴۲٪ کاهش داد.
در بخش چندرسانهای، مدل ترجمهٔ همزمان Qwen3.8-LiveTranslate با کاهش تقریباً ۲۰٪ تأخیر LAAL از ۲٫۸ به ۲٫۳ ثانیه معرفی شد. خانوادهٔ صوتی Qwen-Audio-3.1 شامل ASR، TTS، Realtime و نسخهٔ TTS-Next برای ساخت فضای صوتی سینمایی از اسکریپت متنی نیز اعلام شده و مدل تصویر Qwen-Image 3.1 برای اواخر سال برنامهریزی شدهاست. افزون بر این، راهحل عاملمحور Qwen Intelligence برای سازندگان گوشی معرفی شدهاست.
ابر عاملمحور و زیرساخت بومی هوش مصنوعی
علیبابا کلود ارتقاهایی حول سه لایهٔ مدل، harness و context اعلام کرد؛ از جمله بهینهسازیهای PAI برای آموزش پس از پیشآموزش در حدود پنج روز، سامانهٔ ذخیرهٔ موازی CPFS با کاهش اعلامشدهٔ ۶۹٪ هزینهٔ ذخیرهٔ هوش مصنوعی سازمانی، و شبکهٔ HPN 8.0 Pro با پهنای باند ۱۰۰ پتابیت و پشتیبانی از بیش از ۱۳۰٬۰۰۰ پورت ۸۰۰G در یک خوشه. در لایهٔ ایجنت، پلتفرم AgentCore و مرکز امنیت ایجنت معرفی شده و سرویس Agent Context کاهش تا ۶۷٪ مصرف توکن را در سناریوهایی مانند پشتیبانی، کدنویسی و تحلیل داده گزارش کردهاست. ارتقای OpenLake نیز کاهش ۳۸٪ هزینهٔ کل و ۴۰٪ زمان پاسخ پرسوجو را نسبت به معماریهای سنتی اعلام کردهاست.
جزئیات این اعلامها در بیانیهٔ رسمی علیبابا کلود آمدهاست. رقابت بر سر ظرفیت محاسباتی و مدلهای بزرگ، از دید شما، بیشتر به تراشه وابسته است یا به داده و نرمافزار ابری؟


